Microsoft ha desarrollado tgrep, una herramienta de búsqueda de código que sustituye el escaneo completo de los archivos por un índice basado en trigramas y un servidor que permanece activo en segundo plano. Integrado en GitHub Copilot CLI para grandes repositorios, el sistema ha reducido en sus pruebas una búsqueda de 33,4 segundos con ripgrep a 643 milisegundos en gecko-dev, un repositorio de unos 388.000 archivos.
Las claves de tgrep en 20 segundos
- tgrep construye un índice de trigramas de tres bytes para localizar candidatos sin recorrer todo el repositorio.
- Un servidor mantiene el índice actualizado mediante eventos del sistema de archivos y búsquedas paralelas.
- En gecko-dev, la prueba de macOS pasó de 33.402 a 643 milisegundos de media.
- GitHub Copilot CLI ya utiliza tgrep en grandes monorepositorios bajo determinadas condiciones.
- El proyecto es de código abierto con licencia MIT y suma actualmente unas 3.200 estrellas en GitHub.
Para un agente de programación, buscar dentro de un repositorio es una operación que se repite constantemente. Localizar una función, comprobar referencias, encontrar una configuración o averiguar dónde se modifica una determinada variable puede exigir decenas o cientos de consultas durante una sesión.
La solución habitual es recurrir a herramientas como grep o ripgrep, que destacan por su velocidad y sencillez. El problema aparece cuando el repositorio alcanza cientos de miles de archivos. Aunque cada consulta individual pueda resolverse rápidamente, volver a recorrer todo el contenido una y otra vez termina convirtiendo la búsqueda en una parte apreciable del tiempo que necesita un agente para completar una tarea.
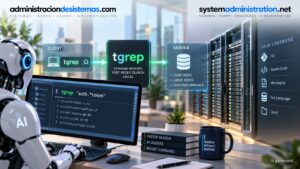
tgrep, desarrollado por Microsoft y publicado como proyecto de código abierto, parte de otra idea: pagar el coste de recorrer el repositorio una vez para después reutilizar esa información. El proyecto describe su funcionamiento como un grep indexado mediante trigramas, con una arquitectura cliente-servidor pensada para búsquedas locales de expresiones regulares en grandes bases de código.
Un índice de tres bytes en lugar de recorrer todos los archivos
El mecanismo central de tgrep consiste en extraer trigramas, cadenas consecutivas de tres bytes, de los archivos de texto. Esos fragmentos se almacenan en un índice invertido que relaciona cada combinación con los archivos en los que aparece.
Cuando llega una consulta, tgrep analiza la expresión regular y extrae de ella los fragmentos literales que pueden convertirse en trigramas. El sistema consulta entonces el índice para determinar qué archivos tienen posibilidades reales de contener una coincidencia.
Solo esos candidatos pasan después por el motor completo de expresiones regulares.
La diferencia con una búsqueda convencional es importante. En lugar de abrir y examinar todos los archivos para cada consulta, el índice permite descartar previamente grandes cantidades de contenido que no pueden coincidir con el patrón buscado. El repositorio de Microsoft explica que el índice utiliza listas ordenadas de archivos y que las operaciones de intersección o unión permiten reducir el conjunto de candidatos antes de realizar la comprobación definitiva.
El índice se almacena en disco y se consulta mediante memory mapping (mapeo de memoria). Esto permite acceder a las estructuras sin cargar todo el índice en la memoria del proceso.
La arquitectura también separa dos capas. IndexReader utiliza el índice persistente y LiveIndex mantiene en memoria los cambios que se producen después de su creación o mientras se actualiza. HybridIndex combina ambas fuentes y da prioridad a la información más reciente.
Eso evita que cada modificación de un archivo obligue a reconstruir todo el índice.
El servidor mantiene caliente la búsqueda
La segunda pieza de tgrep es su servidor. Una vez ejecutado tgrep serve, el proceso mantiene abierto el índice y recibe las consultas de los clientes mediante TCP y JSON-RPC 2.0.
El sistema vigila además los cambios del repositorio. Utiliza notificaciones nativas del sistema operativo cuando están disponibles y puede cambiar a un mecanismo de polling si no consigue mantener una cobertura adecuada de vigilancia.
El objetivo es que el índice no se convierta en una fotografía obsoleta del código.
El proyecto utiliza un índice en memoria para los archivos modificados y un proceso de indexación en segundo plano para incorporar los cambios. También realiza reconciliaciones periódicas para detectar modificaciones que no hayan llegado mediante las notificaciones del sistema de archivos.
La construcción inicial se realiza en paralelo mediante Rayon y se divide en lotes. Cuando el repositorio es especialmente grande, tgrep puede construir el índice mientras los clientes siguen realizando búsquedas: durante esa fase inicial, las consultas recurren a una exploración del sistema de archivos hasta que existe cobertura completa.
El diseño busca así evitar otro problema: que la creación del índice sea tan costosa que anule la ventaja de utilizarlo.
El proyecto también incorpora mecanismos para limitar el consumo de memoria. Su estrategia predeterminada puede volcar segmentos ordenados a disco y realizar después una combinación externa, en lugar de mantener todo el índice invertido en RAM. Según las mediciones publicadas por Microsoft, esta estrategia reduce de forma importante el pico de memoria durante la construcción de índices grandes.
Las pruebas muestran una diferencia mayor cuanto más crece el repositorio
Los resultados publicados por Microsoft muestran que el tamaño del repositorio tiene una relación directa con la ventaja de tgrep.
En gecko-dev, con 387.841 archivos, la batería de 122 consultas registró una latencia media de 33.401,8 milisegundos con ripgrep frente a 643 milisegundos con tgrep en macOS con Apple Silicon. El resultado supone una aceleración de 51,9 veces.
En Windows, la misma prueba pasó de 17.841,2 a 462,6 milisegundos, una diferencia de 38,6 veces. En Linux, donde ripgrep parte de un rendimiento mucho mejor, la ventaja fue de 7,36 veces, con 1.194,9 milisegundos frente a 162,4.
El comportamiento se repite en Chromium, con más de 504.000 archivos. La media fue de 41.806,2 milisegundos para ripgrep frente a 2.643,1 para tgrep en macOS, mientras que Windows registró 24.575,8 frente a 1.396,1 milisegundos.
Pero los números no significan que tgrep sea siempre más rápido. En las 18 combinaciones de repositorio y sistema operativo medidas por el proyecto, ganó en 17. La excepción fue Kubernetes en Linux, donde obtuvo 0,93 veces el rendimiento de ripgrep.
El volumen de resultados también importa. Una consulta que devuelve decenas de miles de coincidencias puede reducir la ventaja del índice porque tgrep tiene que recopilar, transportar y entregar esos resultados a través de su arquitectura cliente-servidor. En ese escenario, el coste de localizar los archivos deja de ser la principal parte del trabajo.
Copilot CLI ya utiliza tgrep en grandes monorepositorios
La conexión con los agentes de programación es una de las partes más relevantes del proyecto. GitHub Copilot CLI ya integra tgrep para realizar búsquedas rápidas en repositorios grandes. La documentación de GitHub indica que Copilot CLI puede cambiar automáticamente de ripgrep a tgrep cuando trabaja dentro de un repositorio Git, en un sistema de archivos no virtualizado y cuando se supera un umbral de número de archivos específico de cada plataforma.
También existe la variable USE_TGREP, que permite forzar o desactivar su utilización bajo determinadas condiciones.
El cambio tiene una consecuencia práctica para los agentes: una operación de búsqueda que antes podía convertirse en una espera de varios segundos puede pasar a resolverse en una fracción mucho menor del tiempo cuando el índice ya está disponible.
Eso no significa que el agente deje de razonar o que la búsqueda sea el único factor que determina la velocidad de una tarea. El modelo sigue necesitando interpretar los resultados, decidir qué archivos consultar y realizar las modificaciones correspondientes. tgrep ataca una parte concreta del proceso: reducir el tiempo dedicado a encontrar dónde está el código relevante.
La diferencia es especialmente importante en repositorios grandes, donde una tarea aparentemente sencilla puede generar una larga cadena de búsquedas. Si cada consulta obliga a revisar cientos de miles de archivos, el coste se acumula. Con un índice persistente, buena parte de ese trabajo se desplaza a la fase de construcción y actualización.
Microsoft mantiene tgrep bajo licencia MIT y el repositorio acumula actualmente alrededor de 3.200 estrellas en GitHub. El proyecto incluye binarios para Linux, macOS y Windows, además de instalación mediante Homebrew y compilación desde código fuente.
La propuesta, por tanto, no intenta reemplazar todas las herramientas de búsqueda de código. Su objetivo está más acotado: hacer que la búsqueda repetitiva en repositorios muy grandes deje de depender de recorrer el mismo contenido una y otra vez.
Para los agentes de programación, esa diferencia puede ser más importante a medida que aumenta el tamaño de los repositorios y las sesiones requieren más operaciones sobre el código. El índice no elimina el trabajo de analizar el repositorio, pero reduce el tiempo necesario para encontrar las piezas sobre las que después debe trabajar el agente.
Preguntas frecuentes
¿Qué es tgrep?
tgrep es una herramienta de búsqueda de código desarrollada por Microsoft que utiliza un índice de trigramas y una arquitectura cliente-servidor para acelerar las búsquedas de expresiones regulares en repositorios grandes.
¿Cuánto más rápido es tgrep que ripgrep?
En las pruebas publicadas por Microsoft, tgrep alcanzó hasta 51,9 veces menos latencia media que ripgrep en gecko-dev sobre macOS. La ventaja depende del tamaño del repositorio, la plataforma y el número de coincidencias que devuelve cada consulta.
¿Por qué tgrep necesita crear un índice?
El índice permite identificar previamente los archivos que pueden contener una coincidencia. Así, una consulta no tiene que examinar todo el contenido del repositorio desde cero.
¿GitHub Copilot CLI utiliza tgrep?
Sí. GitHub indica que Copilot CLI utiliza tgrep en grandes monorepositorios bajo determinadas condiciones y permite controlar su utilización mediante la variable USE_TGREP.