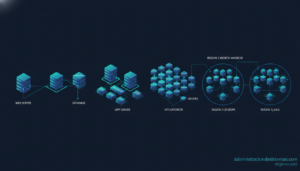
La mayoría de las aplicaciones no necesitan Kafka, microservicios ni una base de datos fragmentada el primer día, y montarlos antes de tiempo solo encarece la factura y complica la operación. Es la tesis de un artículo muy compartido en Medium, firmado por el desarrollador que publica como bektiaw, que recorre cómo debería evolucionar una arquitectura desde un único servidor hasta 100 millones de usuarios activos diarios. Los hitos son orientativos, pero la regla de fondo sirve a cualquier administrador: primero medir y después resolver solo el cuello de botella que se tiene delante.
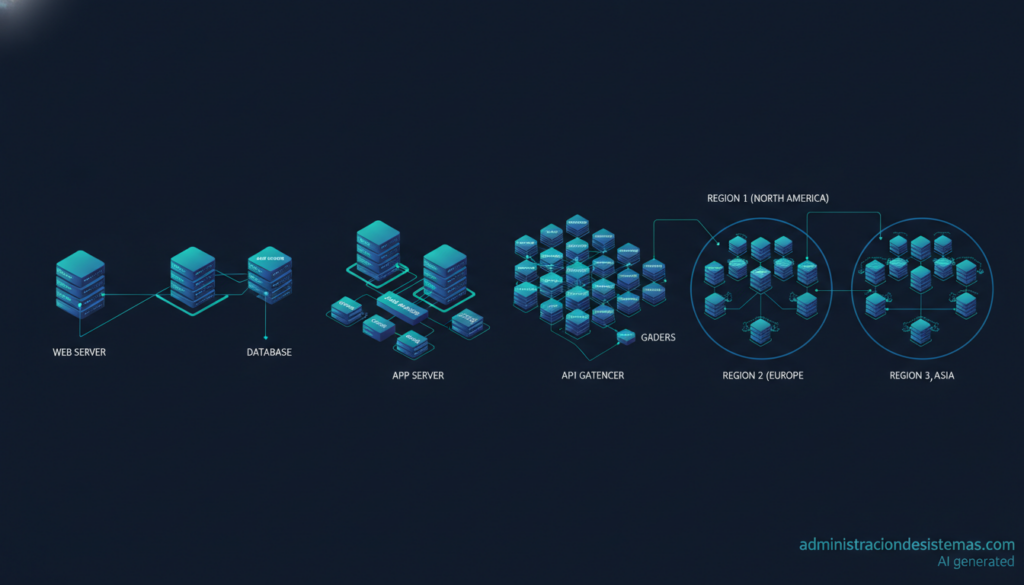
Las claves de escalar una arquitectura de 1 a 100 millones de usuarios en 30 segundos
- Hasta unos 10.000 usuarios diarios suele bastar un único servidor bien configurado.
- Los primeros cambios reales son separar la base de datos, añadir un pool de conexiones, una CDN y un segundo servidor de aplicación.
- Fragmentar la base de datos y pasar a microservicios llega tarde, cuando el problema es el volumen o la coordinación de equipos.
- Con decenas de millones de usuarios mandan la distancia y el coste: varias regiones, fragmentación y arquitectura por celdas.
El texto original parte de una frustración conocida: diagramas de diseño de sistemas llenos de balanceadores, Redis, Kafka y microservicios que impresionan, pero que describen empresas mucho más grandes que aquellas en las que trabaja la mayoría. Su norma es que cada capa de infraestructura llegue solo cuando un problema medido la exija. systemadministration.net, el medio en inglés del mismo grupo editorial, amplió ese recorrido con las cifras y herramientas con las que se encuentra un sysadmin en cada etapa, y este artículo recoge ese análisis.
Pasar de usuarios a peticiones por segundo
Un número de usuarios dice poco hasta que se convierte en carga. La cuenta rápida es multiplicar los usuarios activos diarios por las peticiones que hace cada uno al día, dividir entre los 86.400 segundos del día y aplicar un factor de pico. Con 10.000 usuarios que generan 20 peticiones diarias salen 200.000 peticiones, unas 2,3 por segundo de media. Como el tráfico nunca es plano, un factor de tres a cinco deja la hora punta en torno a 10 peticiones por segundo, la estimación del artículo. Con el mismo comportamiento, 100.000 usuarios suponen unas 100 peticiones por segundo y un millón, alrededor de 1.000.
Son cifras modestas para el hardware actual. Una sola máquina virtual con PostgreSQL o MySQL bien indexado atiende bastante más de 10 peticiones por segundo, y por eso la recomendación inicial es tener aplicación y base de datos en el mismo equipo. Lo importante al principio es lo básico: un modelo de datos limpio, servidores de aplicación sin estado, sesiones fuera de la memoria local, un plan para los archivos que suben los usuarios y copias de seguridad, registros y métricas desde el primer día. Ese servidor único es también el momento de auditar el servidor Linux antes de confiar en él, antes de que se convierta en la plantilla de todo lo demás.
De 10.000 a 100.000 usuarios: base de datos aparte, pool, caché y colas
Los primeros cambios tienen más que ver con la contención y la disponibilidad que con el tráfico. Llevar la base de datos a su propio servidor, o a un servicio gestionado, evita que compita con la aplicación por CPU y memoria. Un pool de conexiones como PgBouncer importa más de lo que muchos equipos creen: PostgreSQL crea un proceso del sistema operativo por conexión y trae max_connections en 100 por defecto, así que unas pocas instancias de la aplicación con pools generosos pueden agotarlo. Según la documentación de PgBouncer, en el modo de pool por transacción la conexión real se devuelve al terminar cada transacción, de modo que cientos de clientes comparten unas decenas de conexiones.
La red de distribución de contenidos (CDN) es, para el autor, el movimiento de escalado más barato y con más retorno, porque saca los estáticos de los servidores de aplicación. Tener dos servidores detrás de un balanceador sirve sobre todo para desplegar sin cortes: uno se actualiza mientras el otro atiende. Administración de Sistemas ya publicó una guía práctica para escalar con balanceadores, réplicas y caché que entra en la configuración de esta fase.
Hacia los 100.000 usuarios la base de datos suele ser la primera en notar la presión, y el arreglo más barato sigue siendo el plan de ejecución. Pasar EXPLAIN ANALYZE por las consultas más lentas descubre índices que faltan y patrones N+1 que ningún hardware compensa. Después llega la caché con Redis o Memcached, normalmente con el patrón cache-aside: la aplicación mira la caché, va a la base de datos si no encuentra el dato y lo guarda. Cada pieza trae su propio fallo. La caché sirve datos obsoletos y puede provocar una estampida cuando caduca una clave muy consultada. Las réplicas de lectura arrastran retraso de replicación, y un usuario que acaba de guardar algo puede no verlo si la lectura siguiente va a una réplica; la solución habitual es mandar al primario durante un rato las lecturas que siguen a una escritura. Las colas como RabbitMQ o Amazon SQS sacan del flujo de la petición los correos, el procesado de imágenes o los informes, pero hay que vigilarlas, porque una cola que crece suele ser la primera señal visible de problemas.
Del millón a los 100 millones: escrituras, equipos y regiones
Los servidores de aplicación escalan en horizontal sin mucho esfuerzo; las bases de datos no, porque cada escritura acaba en el primario y debe ser coherente. El consejo es reducir el problema antes de partirlo. En PostgreSQL, el particionado declarativo, disponible desde la versión 10, permite dividir las tablas grandes por fecha y separar, archivar en almacenamiento más barato o borrar las particiones antiguas sin grandes operaciones DELETE. Conviene también eliminar los índices que no se usan, porque cada índice ralentiza las escrituras, y llevar los eventos de analítica, los registros de auditoría y los contadores a almacenes pensados para datos que solo se añaden. Es la etapa del autoescalado y del trazado distribuido, para seguir una petición lenta entre servicios en lugar de adivinar. El caso de OpenAI, que sostiene ChatGPT con un único primario de PostgreSQL y casi 50 réplicas, muestra hasta dónde puede estirarse este enfoque antes de fragmentar.
A partir de 10 millones de usuarios diarios, sostiene el artículo, el problema principal pasa a ser organizativo: que decenas de ingenieros cambien el sistema sin pisarse. Ahí los microservicios tienen sentido si siguen dominios de negocio o equipos que necesitan desplegar por su cuenta. La comunicación por eventos exige el patrón de bandeja de salida transaccional (transactional outbox), que escribe el cambio y el evento en la misma transacción y lo publica después, para que una actualización no pueda confirmarse con su evento perdido. Limitación de peticiones, contrapresión, tiempos de espera con reintentos exponenciales y cortacircuitos evitan que un servicio lento arrastre a los demás, y las guardias, los runbooks, los objetivos de nivel de servicio (SLO) y los postmortems sin culpables pasan a formar parte de la arquitectura.
Con 100 millones de usuarios mandan la distancia y el coste. Desplegar en varias regiones acerca los servidores a los usuarios y permite sobrevivir a la caída de una región, pero solo si la conmutación se prueba con regularidad. La fragmentación (sharding) se vuelve necesaria y la elección de la clave decide si la carga se reparte o se acumula en unos pocos fragmentos calientes. Las arquitecturas basadas en celdas que documenta AWS dividen la plataforma en copias independientes para que un fallo afecte solo a una parte de los usuarios. El cierre del texto original es lo más útil para quien opera infraestructura: construir el sistema más sencillo que aguante el siguiente crecimiento de diez veces, saber qué cambiará después y no copiar la arquitectura de una empresa mil veces más grande.
Preguntas frecuentes
¿Cuántos usuarios aguanta un solo servidor?
Depende de la carga, pero unos 10.000 usuarios activos diarios, unas 10 peticiones por segundo en hora punta, suelen ser asumibles para un servidor bien configurado con la base de datos indexada.
¿Cuándo hay que añadir PgBouncer?
En cuanto varias instancias de la aplicación comparten un PostgreSQL, porque cada conexión es un proceso y el límite por defecto es de 100 conexiones.
¿Cuándo es necesario fragmentar la base de datos?
Solo cuando la optimización de consultas, la caché, las réplicas, el particionado y el archivado ya no bastan, normalmente a escala muy grande.
¿Conviene empezar un proyecto con microservicios?
Normalmente no. Un monolito bien estructurado es más sencillo de operar; los servicios tienen sentido cuando equipos, despliegues o necesidades de escalado divergen de verdad.
Fuentes: