Los ULID (Universally Unique Lexicographically Sortable Identifier) ocupan los mismos 128 bits que un UUID, pero reservan los primeros 48 para una marca de tiempo, de modo que se pueden ordenar por fecha de creación. Michael Drogalis, creador de ShadowTraffic, lo ha recordado en una publicación en LinkedIn con una recomendación directa: quien use UUID debería plantearse cambiarlos por ULID. El debate en los comentarios muestra que la decisión tiene matices.
Las claves de los ULID frente a los UUID en 30 segundos
- Un ULID tiene 128 bits, como un UUID: 48 de marca de tiempo en milisegundos y 80 aleatorios.
- Se escribe con 26 caracteres en Base32 de Crockford, sin guiones, y se ordena alfabéticamente por fecha.
- Como clave primaria evita la fragmentación de índices que provocan los UUIDv4 aleatorios.
- A cambio, revela cuándo se creó cada registro, y el reloj de cada máquina no garantiza un orden exacto en sistemas distribuidos.
La idea es sencilla. Un UUID versión 4, el más habitual, es una ristra de bits aleatorios: sirve para identificar algo sin colisiones, pero no dice nada de cuándo se generó. Un ULID, según su especificación, codifica en los 48 primeros bits el instante de creación en milisegundos desde 1970 y deja 80 bits aleatorios para evitar choques entre identificadores creados en el mismo milisegundo. El resultado se representa con 26 caracteres en Base32 de Crockford, que no distingue mayúsculas de minúsculas y evita letras confusas como I, L, O y U.
Cómo se lee un ULID
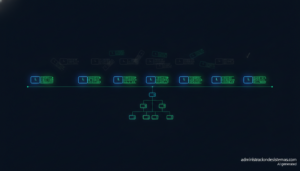
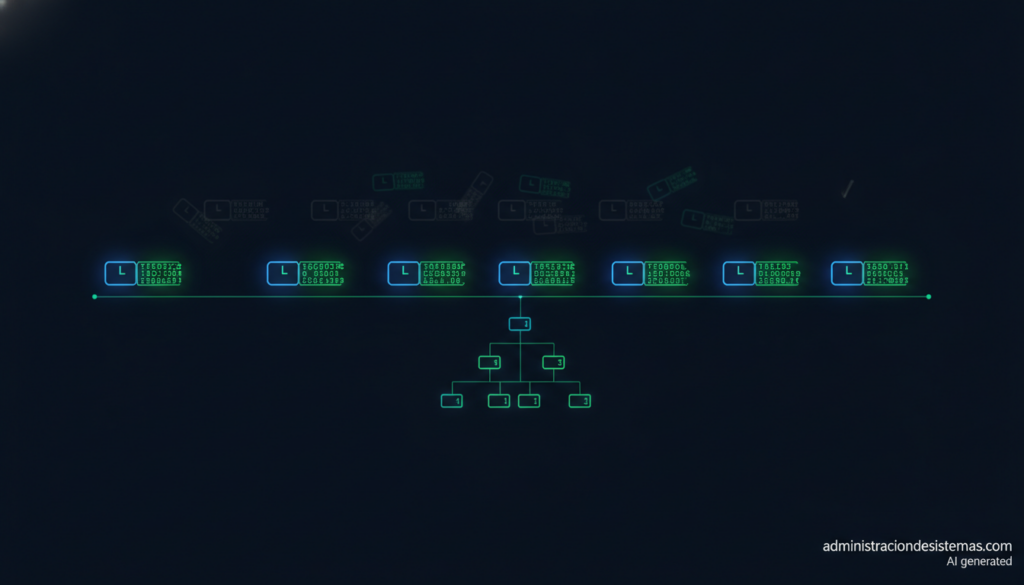
Drogalis lo explica con un ejemplo: 01HX2AY3TN3M5ZFA5TG2WZJZ6G. Los 10 primeros caracteres (01HX2AY3TN) son la marca de tiempo y los 16 restantes (3M5ZFA5TG2WZJZ6G) el valor aleatorio. Para saber cuál de dos ULID se generó antes basta con comparar esa primera parte; como la codificación conserva el orden, ni siquiera hace falta decodificarla, porque una ordenación alfabética da el mismo resultado.
El esquema que acompaña la publicación es ilustrativo y sus cifras no casan del todo entre sí. Si se decodifica con la tabla de Base32 de Crockford, el prefijo 01HX2AY3TN corresponde al 04/05/2024 a las 17:37:54 UTC, no a la fecha que aparece en el gráfico. Para comprobarlo en la práctica, las bibliotecas de ULID incluyen funciones para extraer la marca de tiempo, y existen implementaciones para casi todos los lenguajes habituales.
Por qué importa en la base de datos
La ventaja más práctica para un administrador aparece al usarlos como clave primaria. En los comentarios, el ingeniero Pascal Lüscher resumió el problema: con UUIDv4 como índice agrupado, el motor de base de datos tiene que reorganizar la tabla constantemente, porque cada inserción cae en un punto aleatorio del índice. Con ULID, o con UUIDv7, los nuevos registros se añaden casi siempre al final, lo que reduce la fragmentación y las divisiones de páginas.
Conviene recordar que el estándar UUID ya ofrece una alternativa equivalente. La RFC 9562, publicada en 2024, define UUIDv7, que también empieza por una marca de tiempo Unix de 48 bits en milisegundos y encaja en las columnas de tipo UUID de bases de datos como PostgreSQL. Para quien tenga ya el esquema basado en UUID, puede ser un cambio menos traumático que pasar a ULID, que suele guardarse como texto de 26 caracteres o como binario de 16 bytes.
Lo que se discutió en los comentarios
No todo el mundo compró la idea. Peter Mahon, ingeniero de fiabilidad (SRE), no veía ventajas claras frente a un UUIDv4 acompañado de una columna con la fecha en UTC, más allá del ahorro de espacio, y advirtió de que incrustar la marca de tiempo supone ceder algo de privacidad y seguridad: cualquiera que vea un identificador sabe cuándo se creó. Sean Michael Kelly respondió que un UUIDv4 más una fecha son dos datos donde muchas veces solo cabe uno, y que el ULID evita tener que combinarlos.
Ben Meier, ingeniero de plataformas, destacó un detalle práctico: al no llevar guiones, un ULID se selecciona entero con un doble clic, algo que agradece en el trabajo de operaciones. El propio Drogalis cerró su publicación con una advertencia que cualquier administrador de sistemas distribuidos conoce bien: los relojes de distintas máquinas no están perfectamente sincronizados, así que el orden entre ULID generados en servidores diferentes no es fiable al milisegundo. Dentro de una misma máquina, la especificación prevé un modo monótono que incrementa la parte aleatoria cuando se generan varios identificadores en el mismo milisegundo.
Preguntas frecuentes
¿Qué es un ULID?
Un identificador único de 128 bits que combina una marca de tiempo de 48 bits y 80 bits aleatorios, y que se puede ordenar por fecha de creación.
¿En qué se diferencia un ULID de un UUIDv4?
El UUIDv4 es totalmente aleatorio. El ULID incluye la fecha de creación, se escribe en 26 caracteres de Base32 sin guiones y se ordena alfabéticamente por tiempo.
¿ULID o UUIDv7?
Ambos empiezan por una marca de tiempo de 48 bits. UUIDv7 es un estándar (RFC 9562) compatible con las columnas UUID; ULID usa una representación más compacta.
¿Tienen algún inconveniente los ULID?
Revelan cuándo se creó cada registro y, en sistemas distribuidos, el orden entre máquinas depende de que sus relojes estén sincronizados.
Fuentes: