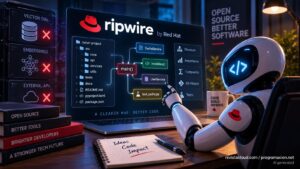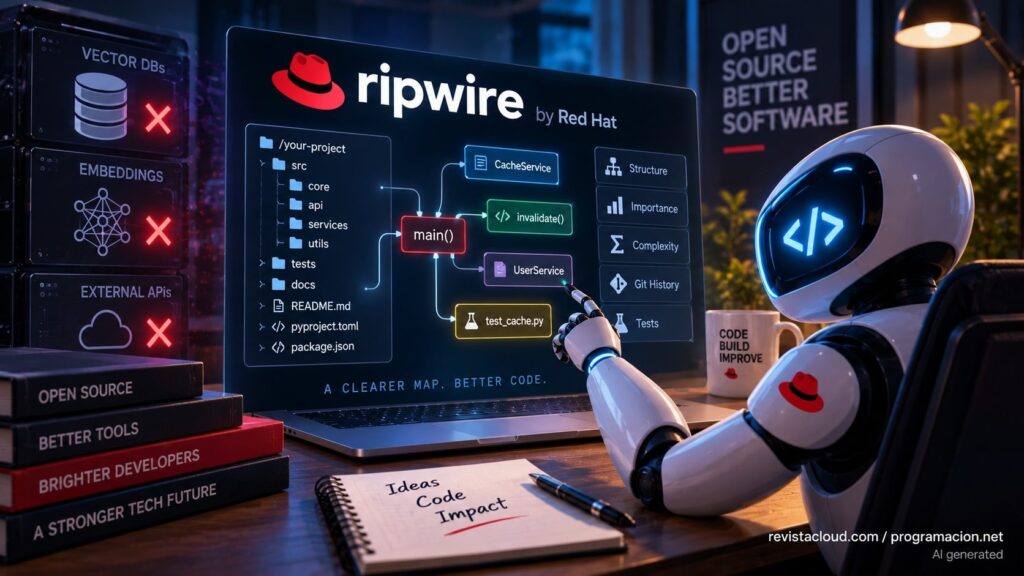
Los agentes de programación necesitan comprender un repositorio antes de modificarlo, una tarea que puede consumir una parte considerable de su ventana de contexto leyendo archivos, ejecutando búsquedas y reconstruyendo relaciones entre funciones. Ripwire, un nuevo proyecto abierto publicado bajo la organización redhat-et, propone un camino diferente: analizar localmente el código y entregar al agente un mapa estructurado y priorizado del proyecto, sin embeddings, API externas ni una base de datos vectorial.
Las claves de Ripwire en 20 segundos
- Ripwire está escrito en C++23 y funciona localmente sin servidor de índices ni claves API.
- Analiza 22 gramáticas y construye mapas estructurados de los repositorios.
- Prioriza símbolos utilizando relaciones, complejidad, historial de cambios y otras señales.
- Puede indicar qué código tocar, su posible impacto y las pruebas relacionadas.
- Sus autores publican pruebas donde reduce ampliamente los tokens frente a estrategias basadas en buscar y leer archivos.
El planteamiento resulta especialmente interesante ahora que herramientas como Codex, Claude Code, Cursor, Gemini, Windsurf, opencode o aider pueden trabajar durante largos periodos sobre proyectos completos.
Un modelo puede tener una enorme ventana de contexto y seguir gastándola de forma poco eficiente.
Cuando recibe una petición como «modifica la invalidación de caché», el agente necesita averiguar dónde se encuentra esa funcionalidad. Puede buscar palabras relacionadas, abrir varios archivos, inspeccionar funciones, localizar quién las llama, buscar pruebas y reconstruir finalmente una pequeña representación mental del proyecto.
Ripwire intenta entregar esa representación antes de que el agente empiece a leer indiscriminadamente.
Un mapa del repositorio en lugar de convertir el código en vectores
Una solución habitual para proporcionar grandes cantidades de información a un modelo consiste en utilizar Retrieval-Augmented Generation (RAG).
Los documentos o fragmentos de código pueden convertirse mediante un modelo de embeddings en representaciones numéricas que posteriormente se almacenan y consultan utilizando sistemas especializados, incluidas bases de datos vectoriales.
Cuando el agente necesita información, una búsqueda semántica recupera los fragmentos considerados más próximos a la consulta.
Ripwire no sigue ese modelo.
El proyecto se presenta como “the ripgrep of AI context” y utiliza análisis estructural del propio código para decidir qué información debe recibir el agente.
Está desarrollado en C++23 y utiliza gramáticas de Tree-sitter integradas en el propio proyecto. Actualmente declara soporte mediante 22 gramáticas, que cubren lenguajes y formatos como Rust, C++, Objective-C, C, CUDA, Python, Go, Swift, TypeScript, JavaScript, Java, Ruby, PHP, Lua, Elixir, Bash, C#, JSON, TOML, YAML y Markdown, entre otros.
No necesita un servidor de indexación permanente, una clave de API ni un servicio de embeddings.
Todo puede ejecutarse localmente.
Esta característica puede resultar especialmente atractiva para repositorios privados porque el análisis no necesita enviar el código a un servicio externo, aunque el nivel final de privacidad dependerá también del agente de IA con el que se utilice.
La herramienta construye relaciones entre símbolos y utiliza diferentes señales para priorizar aquello que considera relevante.
Entre ellas aparecen complejidad ciclomática, estructura de llamadas, frecuencia histórica de modificaciones mediante Git, cobertura de pruebas y otras métricas de calidad.
El resultado no es simplemente una lista de archivos donde aparece una palabra.
El objetivo es responder cuestiones más cercanas a las que se plantea un desarrollador:
| Pregunta del agente | Información que puede proporcionar Ripwire |
|---|---|
| ¿Dónde se gestiona esta función? | Símbolos relevantes ordenados |
| ¿Quién llama a esta función? | Callers |
| ¿Qué utiliza este símbolo? | Usos y relaciones |
| ¿Es peligroso modificarlo? | Radio de impacto |
| ¿Qué pruebas debería ejecutar? | Pruebas relacionadas |
| ¿Qué ha cambiado en el repositorio? | Contexto de Git |
| ¿Qué necesita este PR? | Contexto de la modificación |
| ¿Dónde está el código complejo? | Métricas y hotspots |
La diferencia conceptual es importante.
Una base de datos vectorial intenta responder principalmente a “qué contenido se parece semánticamente a esta pregunta”.
Ripwire intenta responder también a “qué piezas del programa están estructuralmente relacionadas con aquello que se quiere modificar”.
El ahorro de tokens es uno de sus principales argumentos
La propuesta tiene otra consecuencia: reducir la cantidad de código que termina dentro del contexto del modelo.
Los propios responsables de Ripwire han publicado diferentes mediciones. Deben interpretarse como benchmarks del proyecto, no como resultados independientes aplicables automáticamente a cualquier repositorio.
En una de sus comparaciones, preguntar quién llama a una función necesitó alrededor de 580 tokens con Ripwire. La estrategia alternativa basada en buscar el símbolo y abrir posteriormente varios archivos consumió entre 40.000 y 52.000.
Para preparar el contexto de una tarea concreta, Ripwire declara aproximadamente 2.100 tokens frente a entre 16.000 y 80.000 de una lectura completa de los archivos considerados relevantes.
Ante una traza de errores, sus pruebas registran unos 1.400 tokens frente a entre 124.000 y 298.000 mediante búsquedas y posteriores lecturas.
Hay diferencias mucho menores en otras tareas, y el propio proyecto reconoce situaciones donde utilizar la herramienta no compensa. Si una pregunta puede resolverse con un único grep, construir y consultar un mapa aporta menos valor.
También hay que tener cuidado con una cifra promocional especialmente llamativa: Ripwire afirma utilizar aproximadamente el 5 % de los tokens consumidos por una estrategia de búsqueda y lectura en uno de sus escenarios medidos.
Eso no significa que cualquier agente vaya a reducir su factura de tokens un 95 %.
Dependerá del repositorio, de la pregunta, del modelo, del flujo utilizado y de cuánto código hubiera leído el agente sin Ripwire.
Sus responsables publican precisamente las condiciones de las mediciones y algunos resultados negativos, algo necesario para interpretar correctamente las comparaciones.
¿Significa esto el final de las bases de datos vectoriales?
No.
Presentar Ripwire como el sustituto universal de los embeddings o de las bases de datos vectoriales sería ir más allá de lo que demuestra el proyecto.
Ambas tecnologías resuelven problemas diferentes.
Las búsquedas vectoriales siguen teniendo utilidad cuando un agente necesita encontrar relaciones semánticas en grandes cantidades de documentación, conversaciones, tickets, conocimiento empresarial o contenido no estructurado.
Ripwire está especializado en repositorios de software, donde existen señales que un documento convencional no tiene: funciones, llamadas, tipos, dependencias, complejidad, modificaciones de Git y pruebas.
| Enfoque | Punto fuerte |
|---|---|
| Grep / búsqueda textual | Coincidencias exactas y rapidez |
| Embeddings + Vector DB | Similitud semántica |
| Lectura directa del repositorio | Máximo detalle |
| Ripwire | Estructura y relaciones del código |
| Herramientas compiler-grade | Relaciones de código con mayor precisión |
Incluso dentro del código existen limitaciones.
Ripwire reconoce que un grafo basado en nombres no puede identificar perfectamente comportamientos como dynamic dispatch, determinadas llamadas indirectas, callbacks mediante tablas o símbolos generados exclusivamente después de expandir macros.
La herramienta incorpora indicadores para advertir cuando una respuesta puede ser incompleta y permite escalar hacia análisis más precisos.
Por tanto, su propuesta no consiste tanto en eliminar RAG como en evitar utilizar RAG indiscriminadamente para un problema que también puede resolverse aprovechando la estructura del software.
De darle archivos al agente a darle exactamente lo que necesita
Esta idea puede adquirir más importancia conforme los agentes de programación ganen autonomía.
Una ventana de contexto grande no es gratuita. Cuanto más contenido irrelevante recibe un modelo, más tokens se procesan y mayor puede ser la dificultad para mantener la atención sobre las partes realmente necesarias.
Ripwire utiliza presupuestos de tokens para limitar explícitamente cuánto contexto entrega.
También puede enviar únicamente las firmas de determinadas funciones en lugar de sus cuerpos completos. El proyecto afirma haber medido una reducción del 80,2 % en bytes utilizando esta representación para los 50 elementos principales.
Si posteriormente el agente necesita inspeccionar una función concreta puede solicitar su contenido.
Es un modelo parecido a cómo trabaja un programador experimentado.
Al entrar en un proyecto desconocido no empieza necesariamente leyendo todos los archivos de principio a fin. Primero intenta comprender su arquitectura, identifica módulos relevantes, localiza las funciones importantes y profundiza allí donde encuentra una relación con la tarea.
Ripwire pretende automatizar esa selección.
Además dispone tanto de una interfaz de línea de comandos (CLI) como de un servidor Model Context Protocol (MCP).
Curiosamente, sus desarrolladores recomiendan empezar por la CLI. Su argumento es que registrar permanentemente numerosas herramientas MCP también consume contexto porque los esquemas de esas herramientas tienen que estar disponibles para el agente durante la sesión.
La herramienta puede integrarse con Codex, Claude Code, Cursor, Windsurf, Gemini, opencode y aider, y se distribuye bajo licencia Apache 2.0.
Los autores también han construido un conjunto amplio de funciones para evaluar el repositorio: análisis de impacto, detección de hotspots, métricas de complejidad, revisión de cambios, selección de pruebas y diferentes indicadores de calidad.
En sus pruebas de recuperación sobre LocBench, Ripwire declara encontrar todos los archivos considerados correctos dentro de los diez primeros resultados en el 58,3 % de los casos, frente al 40 % obtenido por la mejor alternativa incluida en esa comparación. De nuevo, son mediciones publicadas por el propio proyecto y deberán contrastarse en más repositorios y escenarios.
La propuesta de fondo, sin embargo, resulta relevante independientemente de esos porcentajes.
Hasta ahora buena parte de la industria ha intentado resolver el contexto de los agentes aumentando ventanas, creando embeddings y almacenando más información para recuperarla posteriormente.
Ripwire plantea otra posibilidad: hacer que el agente lea menos porque alguien ya ha organizado el repositorio antes de entregárselo.
Si ese enfoque funciona de forma consistente en proyectos grandes, el ahorro no estaría únicamente en el coste de los embeddings o de una base de datos vectorial.
Estaría en algo posiblemente más valioso: los millones de tokens que los agentes consumen intentando descubrir una y otra vez cómo está construido el software sobre el que trabajan.
Preguntas frecuentes
¿Qué es Ripwire?
Ripwire es una herramienta abierta publicada bajo la organización redhat-et que analiza repositorios de software y proporciona a agentes de programación un mapa priorizado de símbolos, relaciones, impacto y pruebas relevantes.
¿Ripwire necesita embeddings o una base de datos vectorial?
No. La herramienta funciona sin embeddings, claves API o servidor de índices externo y puede realizar el análisis localmente.
¿Ripwire puede utilizarse con Codex y Claude Code?
Sí. El proyecto contempla integración con Codex, Claude Code, Cursor, Windsurf, Gemini, opencode y aider, mediante CLI, MCP o mecanismos específicos según el agente.
¿Ripwire sustituye a una Vector DB?
No de forma general. Puede evitar su necesidad en determinados flujos de contexto sobre repositorios de código, pero las bases vectoriales continúan resolviendo problemas de recuperación semántica que Ripwire no pretende cubrir.