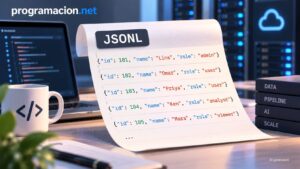
JSONL, siglas de JSON Lines, organiza los datos como objetos JSON independientes, uno por línea, y esa diferencia permite procesar grandes archivos de forma incremental. El formato resulta especialmente útil para registros, flujos de eventos, datos de aprendizaje automático y procesos de extracción y transformación en los que cargar todo el contenido en memoria no resulta práctico.
Las claves de JSONL en 20 segundos
- Cada línea contiene un objeto JSON completo e independiente.
- Permite leer y procesar registros sin cargar todo el archivo en memoria.
- Encaja con logs, eventos, datos de aprendizaje automático y procesos ETL.
- Herramientas como pandas, Spark, Hadoop o jq pueden trabajar con este formato.
- JSON sigue siendo más adecuado para configuraciones, APIs y estructuras pequeñas o jerárquicas.
La diferencia frente al JSON convencional es muy pequeña en apariencia, pero cambia la forma en la que una aplicación puede leer los datos. Un documento JSON tradicional tiene una única estructura raíz, normalmente un objeto o un array que contiene todos los registros. JSONL separa esos registros y hace que cada línea sea una unidad independiente.
Por ejemplo, un archivo JSON puede contener un array con cientos o millones de objetos. Para procesarlo con un analizador que utilice un enfoque de carga completa, el programa necesita construir esa estructura antes de comenzar a trabajar con los registros. En JSONL, en cambio, puede leer una línea, convertirla en un objeto, procesarla y continuar con la siguiente.
El concepto no requiere una nueva sintaxis JSON. Los objetos siguen utilizando JSON válido. Lo que cambia es la organización de varios objetos dentro del archivo.
La diferencia entre JSON y JSONL está en cómo se organiza la información
Un archivo JSON convencional podría agrupar varios registros de esta forma:
{
  "records": [
    {"id": 1, "name": "Juan", "status": "active"},
    {"id": 2, "name": "Maria", "status": "inactive"},
    {"id": 3, "name": "David", "status": "active"}
  ]
}Lenguaje del código: JSON / JSON con comentarios (json)
En JSONL, cada registro ocupa su propia línea:
{"id": 1, "name": "Juan", "status": "active"}
{"id": 2, "name": "Maria", "status": "inactive"}
{"id": 3, "name": "David", "status": "active"}Lenguaje del código: JSON / JSON con comentarios (json)
Esa estructura permite utilizar operaciones de lectura de archivos convencionales para recorrer los registros uno a uno. Si el archivo contiene 50 MB, por ejemplo, un procesamiento basado en líneas no necesita mantener los 50 MB completos en memoria. Necesita espacio para la línea que está procesando y para las estructuras que genere la aplicación.
Eso no significa que JSONL sustituya a los analizadores JSON capaces de trabajar de forma incremental. Herramientas como ijson en Python o stream-json en Node.js permiten procesar estructuras JSON complejas sin cargarlas completamente. La diferencia es que esos analizadores conservan una estructura jerárquica, mientras que JSONL apuesta por registros independientes y facilita una lectura basada en líneas.
Esta característica resulta especialmente útil cuando los datos no dejan de crecer o llegan progresivamente. Un archivo de logs es un ejemplo sencillo: cada nuevo acontecimiento puede añadirse como un nuevo registro sin tener que reconstruir un array JSON completo.
También ayuda cuando distintas partes de un sistema necesitan consumir registros de manera independiente. La separación por líneas hace que el formato sea más sencillo de dividir y procesar en paralelo, especialmente en herramientas diseñadas para trabajar con datos distribuidos.
Logs, IA y procesos de datos son algunos de sus usos
Los archivos de registros son uno de los casos más claros. Una aplicación puede ir añadiendo eventos conforme ocurren y otro proceso puede leerlos progresivamente. La estructura también encaja con datos de telemetría, errores y otros registros que se acumulan con el tiempo.
Los flujos de datos para aprendizaje automático constituyen otro escenario relevante. Los conjuntos de entrenamiento pueden contener grandes cantidades de ejemplos y JSONL permite recorrer los registros de forma incremental. El texto de referencia cita el soporte de JSONL en la biblioteca datasets de Hugging Face como ejemplo de esta utilización.
Los sistemas de procesamiento de grandes volúmenes de datos también pueden beneficiarse del formato. Apache Spark y Hadoop pueden dividir archivos JSONL siguiendo las líneas, lo que simplifica el procesamiento distribuido. Un JSON compuesto por estructuras anidadas requiere más cuidado para determinar dónde puede realizarse una división sin romper su estructura.
Los procesos ETL, siglas de extracción, transformación y carga, encuentran una ventaja similar. Los registros independientes pueden añadirse, transformarse o procesarse por separado, mientras que las herramientas que ya reconocen JSONL evitan que cada proyecto tenga que diseñar un formato propio.
El formato también aparece en escenarios de mensajería y streaming. Cuando cada evento constituye una unidad independiente, la separación por líneas encaja con un procesamiento progresivo. El artículo original menciona además las API que entregan resultados de manera incremental, aunque señala que OpenAI utiliza Server-Sent Events (SSE), un mecanismo diferente en el que cada evento puede contener un objeto JSON.
Otro aspecto relevante es la estandarización. Es posible crear un archivo con objetos JSON separados por saltos de línea sin utilizar la denominación JSONL, pero hacerlo mediante un formato reconocido permite recurrir a herramientas que ya saben interpretarlo. El texto menciona pandas, Spark, Hadoop y jq entre las opciones disponibles.
Para un equipo de desarrollo, la extensión .jsonl también comunica cómo está organizado el archivo. Eso evita tener que documentar una convención interna que, técnicamente, ya tiene equivalentes establecidos en el ecosistema.
JSON sigue teniendo ventajas en otros escenarios
La utilidad de JSONL no implica que JSON convencional haya dejado de tener sentido. Las aplicaciones web y las API REST continúan utilizando JSON de forma generalizada. Los clientes y servidores disponen de soporte directo y JavaScript incorpora las funciones JSON.parse() y JSON.stringify().
Los archivos de configuración son otro caso en el que un único documento JSON puede resultar más natural. Si la configuración es pequeña y tiene una estructura jerárquica, mantenerla como un único objeto permite cargarla completa y acceder a sus diferentes niveles.
La misma consideración se aplica a los conjuntos de datos pequeños o medianos que caben cómodamente en memoria. En esos casos, separar cada registro en una línea puede aportar poco y añadir una forma adicional de procesamiento.
La decisión depende, por tanto, de la estructura y del modo en que se consumen los datos. Cuando la aplicación necesita tratar un documento completo y mantener relaciones jerárquicas, JSON encaja con ese modelo. Cuando existen muchos registros independientes que deben llegar o procesarse progresivamente, JSONL ofrece una estructura más adecuada.
JSONL y NDJSON son prácticamente equivalentes
Otra denominación que aparece con frecuencia es NDJSON, abreviatura de Newline-Delimited JSON. El concepto descrito en el artículo es prácticamente el mismo: objetos JSON independientes separados por saltos de línea.
La diferencia que plantea el texto está principalmente en la denominación y la extensión utilizada. Un archivo .jsonl se identifica habitualmente como JSON Lines, mientras que .ndjson identifica Newline-Delimited JSON. En ambos casos, la idea central consiste en que cada línea contiene un objeto JSON completo.
Para los desarrolladores, esta distinción importa menos que comprobar qué formato espera la herramienta concreta con la que trabajan. El nombre del archivo puede servir como señal, pero la compatibilidad final depende del sistema que vaya a leerlo.
El artículo también plantea por qué JSONL no recibe tanta atención como otras tecnologías de procesamiento de datos. Su principal característica es precisamente que apenas añade complejidad: utiliza JSON, mantiene cada registro independiente y aprovecha herramientas que ya existen.
Ese carácter sencillo explica buena parte de su utilidad. Para una aplicación que genera logs o procesa grandes cantidades de registros, no siempre hace falta introducir una infraestructura especializada para comenzar a trabajar de forma incremental. Un formato basado en líneas puede ser suficiente para resolver una parte del problema.
La cuestión práctica pasa por determinar si los datos están acotados y deben tratarse como una única estructura o si son grandes, crecen continuamente y pueden procesarse registro a registro. En el segundo escenario, JSONL puede evitar que el tamaño total del archivo determine los requisitos de memoria del proceso.
Preguntas frecuentes
¿Qué es JSONL?
JSONL significa JSON Lines. Es un formato en el que cada línea contiene un objeto JSON independiente y completo.
¿Qué diferencia hay entre JSON y JSONL?
JSON representa un único documento con una estructura raíz, mientras que JSONL organiza múltiples objetos JSON independientes, normalmente uno por línea. Esta estructura permite procesar los registros de manera incremental.
¿Para qué se utiliza JSONL?
Se utiliza especialmente en logs, flujos de eventos, conjuntos de datos de aprendizaje automático, procesamiento de grandes volúmenes de datos y procesos ETL.
¿JSONL y NDJSON son lo mismo?
El artículo trata JSONL y NDJSON como formatos prácticamente equivalentes, ambos basados en objetos JSON delimitados por saltos de línea. La diferencia habitual está en la denominación y en la extensión utilizada.
Fuentes:
- Level Up Coding / GitConnected, “JSONL: The Format We Didn’t Know We Needed”, Dave Taubler, 04/09/2026.
- JSONL Tools, “JSONL vs JSON: Key Differences, Examples, and Use Cases”.
- Scrapfly Blog, “JSONL vs JSON”.
- JSONL Tools, “JSONL vs NDJSON: Same Format, Different Names”.
- JSONL Help, herramientas y utilidades para JSONL.